검색 엔진 내재화 PoC
외부 AI 검색을 자체 하이브리드 검색으로 바꿔 검색 품질 약 21.1% 향상
문제와 배경
- 상품 검색 전체를 외부 AI 검색 서비스에 맡겼는데 무관한 상품이 상위에 노출돼 사용성 테스트(UT) 참여자 대부분이 검색 품질에 불만을 언급
- 응답이 상품별 점수 하나뿐인 블랙박스라 순위 근거를 알 수 없음. 튜닝할 수 없었고 "왜 이 상품이 나오나"는 CS에도 답하지 못함
- 외부 장애가 1~2주에 한 번꼴로 발생. 서킷브레이커로 외부 호출을 끊고 DB 검색으로 fallback해 장애 전파는 막았음
- 하지만 fallback인 DB 검색은 상품명
LIKE '%검색어%'라 띄어쓰기, 오타, 동의어 변형을 못 잡고 관련도 순위도 없어 장애 때마다 품질이 더 크게 떨어짐
- 하지만 fallback인 DB 검색은 상품명
- 품질도 가용성도 외부에 맡긴 구조를 바꿔야 한다고 판단해 OpenSearch 기반 검색 엔진 내재화 PoC를 팀에 제안하고 설계, 구현, 평가까지 전담
해결 과정
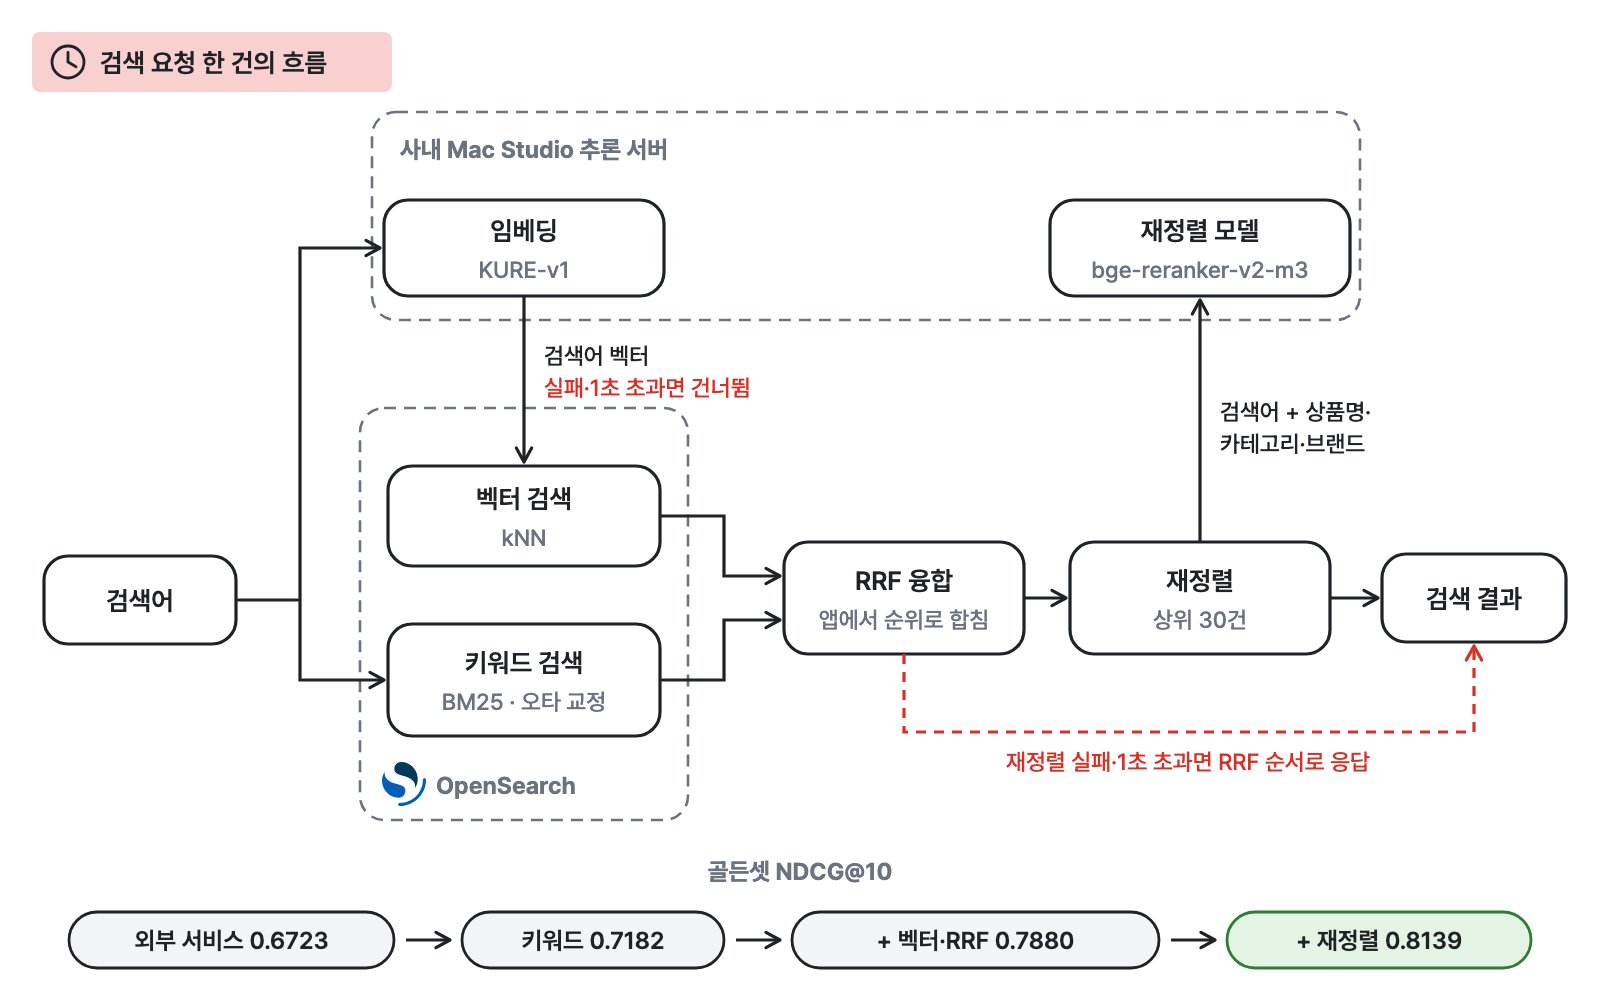
- 평가 기준(골든셋)을 먼저 만들고 검색 엔진을 고른 뒤 키워드 검색, 벡터 검색과 RRF 융합, cross-encoder 재정렬을 차례로 붙이며 단계마다 NDCG@10으로 검증함
평가 기준(골든셋)
- 실제 검색어 150개에 대해 외부 서비스와 우리 검색의 결과 상품마다 관련도 0~3 등급을 매긴 골든셋을 만듦(LLM 판정 후 사람 검수). 두 검색을 같은 골든셋으로 NDCG@10(상위 10건 순위 품질 지표) 채점하고, 모델과 설정을 바꿀 때마다 자동 재채점해 비교함
검색 엔진 선택
- 처음엔 운영 DB(PostgreSQL)에 PGroonga와 pgvector 확장을 올려 별도 인프라 없이 검색하려 했음. 하지만 NCP 관리형 DB가 PGroonga를 지원하지 않았고, 가능했더라도 주문과 결제 트랜잭션이 도는 운영 DB에 검색 부하가 얹힘. PostgreSQL을 따로 띄우면 별도 저장소 운영과 색인 동기화 부담이 검색 전용 엔진과 같아짐
- 그래서 한국어 형태소 분석(nori), BM25, kNN을 한 엔진에서 무료(Apache 2.0)로 제공하는 OpenSearch를 택함. 사용자 사전, 동의어, 불용어 파일을 계속 손봐야 하는데 관리형 OpenSearch는 이 파일 관리가 어려워 클러스터를 셀프 호스팅함
[1단계] 키워드 검색(BM25)
- 후보 회수(recall) 단계에 BM25를 둠. 검색어 토큰과 상품명의 일치도로 점수를 매겨 LIKE 검색에 없던 관련도 순위가 생김
- 상위 3건의 상품명에 검색어가 없으면 term suggester로 색인된 단어 중 편집 거리가 가까운 단어로 교정해 재검색함(
총이컵→종이컵)
[2단계] 벡터 검색 + RRF 융합
- 키워드 검색은 토큰이 일치해야 하므로 오타 교정으로 못 잡는 오타와 표기 변형(
나랑그→나랑드사이다,짱아찌간장→장아찌간장)을 놓침. 그래서 상품명 임베딩 kNN으로 의미가 가까운 상품을 회수하는 벡터 검색을 더함 - 두 결과는 순위 기반 RRF로 융합. BM25 점수와 코사인 유사도는 스케일이 달라 그대로 더할 수 없고, 정규화 후 가중합해도 골든셋 NDCG@10이 RRF보다 낮았음
- 임베딩 모델은 외부 API(OpenAI, Upstage Solar)와 사내 Mac Studio에서 셀프 호스팅하는 공개 모델을 비용, 처리 시간, 품질로 비교해 KURE-v1을 고름
임베딩 후보 비교 (비용과 처리 시간은 상품 200만 건 색인 1회 기준, 품질은 재정렬 없이 잰 골든셋 NDCG@10)
| 후보 | 비용 | 처리 시간(등급별 rate limit에 따라 다름) | 품질(NDCG@10) | 판단 |
|---|---|---|---|---|
| OpenAI text-embedding-3 (small, large) | $0.6~3.8 | 무료 등급 약 12시간, 최고 등급 약 3분 | 약 0.761, 0.762 | |
| Upstage Solar | 약 $1.7 | 기본 등급(RPM 100) 약 3시간 20분, 최고 등급 약 1분. 한도 초과 시 429로 임베딩 누락 | 약 0.805 | |
| KURE-v1 (Mac Studio, 한국어 검색용 공개 모델) | 없음 | 약 18분, rate limit 없음 | 0.7880 | 채택 |
- PoC라 모델이나 임베딩 입력을 바꿀 때마다 전체 상품을 재임베딩해야 했는데, 외부 API는 rate limit 때문에 한 번에 몇 시간씩 걸리고 줄이려면 월 $100 이상 선결제 등급이 필요했음. 품질은 Solar가 가장 높았지만 재정렬 후에는 차이가 거의 없어(Solar 약 0.815, KURE-v1 0.8139) 비용 없이 실험을 반복하도록 기존 Mac Studio에서 KURE-v1을 셀프 호스팅함. 비용 제약이 없었다면 Solar를 썼을 것
[3단계] cross-encoder 재정렬
- BM25와 kNN(bi-encoder)은 검색어와 상품을 따로 보고 점수를 내고 RRF는 순위만 합치므로, 검색어 토큰 일부만 강하게 맞는 상품이 상위에 옴.
서울우유 치즈는 우유와 요구르트인 서울우유 제품이 1~6위를 차지하고 서울우유 치즈는 7위에야 나왔고,두부는 두부 김치찌개와 두부두루치기 양념이 두부 사이에 끼어 있었음 - 그래서 검색어와 상품 정보(상품명, 소카테고리, 브랜드)를 한 쌍으로 입력받아 관련도를 직접 판정하는 cross-encoder로 상위 후보를 재정렬함. 재정렬 뒤
서울우유 치즈는 서울우유 치즈 제품이 1~5위를 채움. 모델은 골든셋 품질이 가장 높고 라이선스 문제가 없는 bge-reranker-v2-m3 - 재정렬은 모든 검색의 핫패스라 지연이 응답에 그대로 더해짐. fp16 전환과 재정렬 깊이 50→30건으로 p95 565ms → 231ms(Mac GPU 기준). 31위 밖 정답은 못 올리지만 NDCG@10 손실이 0.007뿐이라 30건 채택
실패 대비
- 임베딩과 재정렬은 별도 추론 서버 호출이라 실패와 지연 가능. 임베딩이 실패하거나 타임아웃(1초)이면 벡터 검색을 건너뛰고 키워드 결과만 재정렬하고, 재정렬이 실패하거나 타임아웃이면 RRF 순서로 응답함. 어느 경우든 LIKE 검색으로 fallback하지 않음
결과
- 골든셋 NDCG@10 외부 검색 서비스 0.6723 → 0.8139(약 +21.1%)
- 단계별 점수가 보여 순위 원인을 추적하고 사전과 동의어로 튜닝할 수 있음
- 임베딩과 재정렬이 모두 실패해 키워드 검색만 남는 최악의 경우에도 외부 검색 서비스보다 품질이 높음
구성별 NDCG@10 (골든셋 150개)
| 구성 | 이 구성으로 응답하는 실패 상황 | NDCG@10 |
|---|---|---|
| (비교) 외부 검색 서비스 | 0.6723 | |
| 키워드 검색 | 임베딩과 재정렬 모두 실패 | 0.7182 |
| 키워드 검색 + 재정렬 | 임베딩 실패 | 0.7389 |
| 키워드 + 벡터 검색(RRF) | 재정렬 실패 | 0.7880 |
| 키워드 + 벡터 검색 + 재정렬 | 정상 | 0.8139 |