03 토픽·파티션 상세 개념
백엔드 개발자는 어떤 이벤트를 한 토픽에 모을지, 어떤 키로 파티션을 정할지, 몇 개의 파티션이 필요한지 결정할 수 있어야 한다.
1. 토픽과 파티션의 관계
- 토픽: 같은 목적의 레코드를 모으는 논리적 이름. ex)
orders.events - 파티션: 토픽을 나눈 실제 로그. 레코드는 파티션 하나에 추가되며, 그 안에서 오프셋을 받는다. 오프셋
5는 토픽 전체가 아닌 특정 파티션의 위치다. - 각 파티션은 브로커에 배치된다. 여러 파티션을 여러 브로커에 나눠 쓰고 읽을 수 있다.
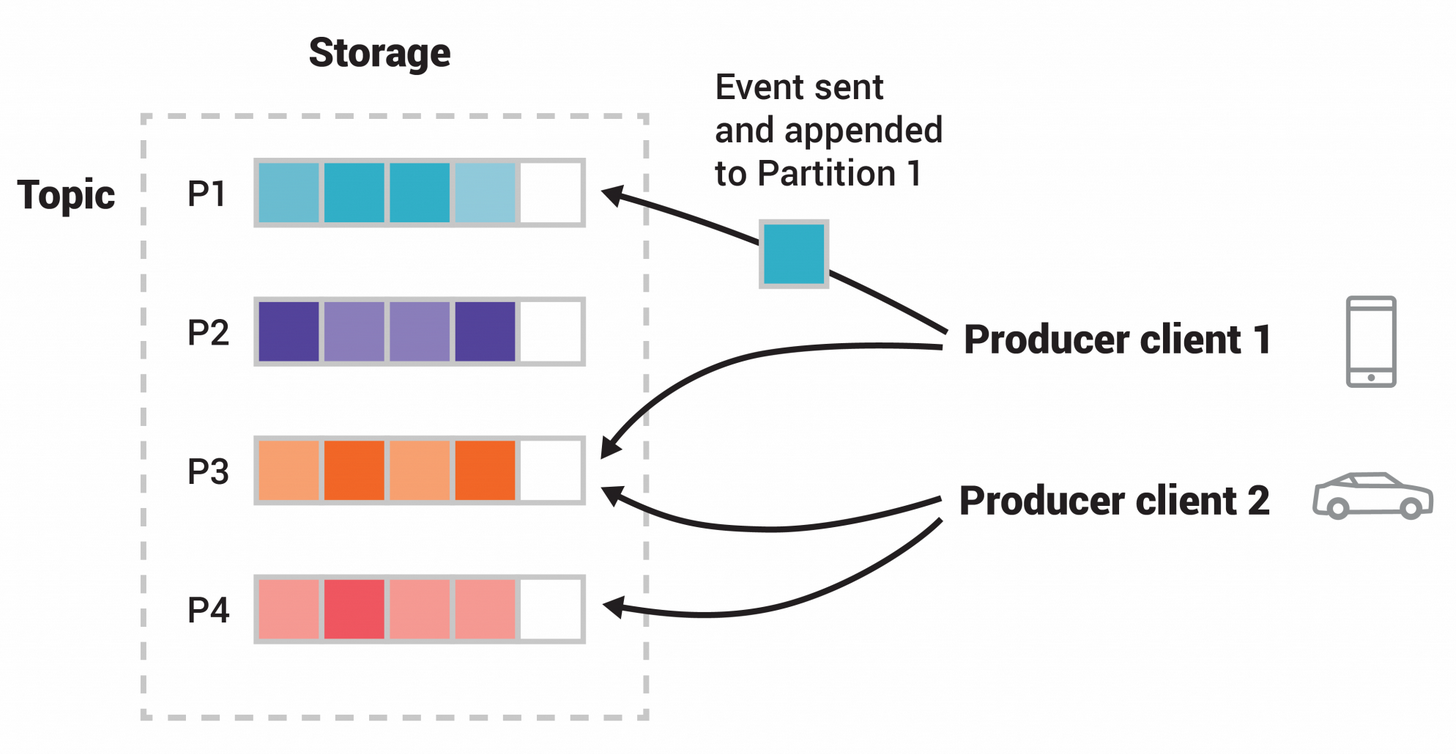
한 토픽이 P1~P4 네 파티션으로 나뉘고, 프로듀서가 보낸 이벤트는 그중 한 파티션의 끝에 추가된다. 같은 색은 같은 키의 이벤트로, 같은 파티션에 모인다.
이미지 출처: Apache Kafka 공식 소개
2. 메시지 키가 순서를 결정한다
주문 123의 생성 → 결제 → 취소를 순서대로 다뤄야 한다면 주문 ID를 키로 보낸다. 같은 키는 같은 파티션으로 가므로, 그 파티션에 기록된 순서대로 읽을 수 있다. 단, 토픽 전체의 순서는 보장되지 않는다.
- 프로듀서가 기본 파티셔너를 사용한다면, 같은 키가 같은 파티션으로 간다. 하지만 파티션 개수나 파티셔너 설정이 바뀌면 같은 키가 다른 파티션으로 갈 수 있어, 바뀌기 전후의 순서가 보장되지 않는다.
- 순서가 중요한 토픽은 아래 4절의 전환 절차로 기존 이벤트를 먼저 처리한다. 무중단 증설에는 키별 배정을 고정하는 별도 설계가 필요하다.
- 서로 다른 프로듀서가 동시에 같은 키를 보내면, 실제 파티션에 기록된 순서가 업무상 발생 순서와 다를 수 있다.
- Kafka가 보장하는 것은 파티션 내 기록·읽기 순서다. 컨슈머가 읽은 뒤 비동기로 병렬 처리하면 완료 순서는 애플리케이션이 관리해야 한다.
3. 파티션 수가 병렬성의 상한이다
일반 컨슈머 그룹에서 파티션 하나는 한 컨슈머가 맡는다.
ex) orders.events에 파티션 4개, 결제 그룹에 컨슈머 2개면 각 컨슈머가 대략 2개씩 맡는다. 컨슈머가 5개면 최소 1개는 할당받지 못한다.
Kafka 4.2부터 정식 기능인 share group은 한 파티션을 여러 컨슈머가 나눠 읽으므로 이 상한이 없다. 대신 키별 처리 순서를 기대할 수 없다(Kafka 4.2 업그레이드 노트).
파티션 수를 정할 때는 피크 이벤트 유입량, 컨슈머 1개의 실제 처리량, 앞으로 필요한 병렬 컨슈머 수를 함께 본다. 특정 키에 이벤트가 몰리면 해당 파티션만 바빠지는 핫 파티션이 생긴다. 이때 파티션만 늘려도 한 키의 처리는 분산되지 않는다. 파티션이 많을수록 브로커의 저장·관리 비용도 늘어난다.
처리량 계획: 한 토픽·일반 컨슈머 그룹의 대략적인 상한은 min(파티션 수, 컨슈머 수) × 컨슈머 1개의 실측 처리량이다. 파티션별 트래픽 쏠림과 DB·외부 API 병목이 있으면 실제 처리량은 더 낮다.
유입량 > 소비량이 지속되면 컨슈머 랙과 처리 지연이 늘어난다. 컨슈머는 poll()을 반복 호출해 브로커에서 레코드를 당겨 오고, pause()로 특정 파티션 읽기를 멈췄다가 resume()으로 다시 읽을 수 있다(KafkaConsumer pause/resume). 하지만 읽기를 멈춰도 프로듀서는 느려지지 않는다. 유입이 계속 빠르면 랙이 쌓이고, 보관 기간(또는 크기 한도)을 넘기면 처리 전 데이터가 삭제된다. Kafka가 막히는 지점별로 어떻게 동작하는지는 백프레셔 노트의 4.2절, 랙이 보관 한도를 넘었을 때 생기는 일은 4.3절에서 다룬다.
- 먼저 소비 로직과 외부 시스템 호출 시간을 측정해 컨슈머 1개의 처리량을 높인다. 그다음 파티션 여유가 있으면 컨슈머를 추가한다. 병목이 다른 곳에 있으면 파티션을 늘리거나 서버 사양을 높여도 효과가 없다.
- 하루 평균 대신 피크 시간의 초당 유입량, 실제 처리량, 랙 증가 속도, 허용 지연을 본다. 운영 지표와 운영에 가까운 부하 시험으로 여유를 잡고, 파티션 증가에 따른 브로커 비용도 확인한다.
4. 파티션 수 변경 시 주의
Kafka는 파티션을 추가할 수 있지만 기존 레코드를 새 파티션으로 옮기지 않고, 파티션 수를 줄이는 기능은 지원하지 않는다. 파티션을 늘리면 키의 파티션 배정이 바뀔 수 있다. 같은 주문의 과거·새 이벤트가 서로 다른 파티션에서 동시에 처리되면 순서가 깨진다.
순서가 중요한 토픽의 간단한 증설 절차
- 해당 토픽에 쓰는 모든 프로듀서를 잠시 멈추고, 전송 중인 이벤트의 저장 성공을 확인한다.
- 순서에 의존하는 모든 컨슈머 그룹이 기존 이벤트를 처리·오프셋 커밋할 때까지 기다린다(랙 0 확인).
- 파티션 수를 늘리고 컨슈머가 새 파티션을 할당받았는지 확인한 뒤 프로듀서를 재개한다. 새 파티션에는 커밋 오프셋이 없다. 이때 어디서부터 읽을지는
auto.offset.reset이 정하고, 기본값latest는 컨슈머가 할당받은 뒤 들어온 레코드부터 읽는다. 그래서 컨슈머 할당 전에 발행하지 않는다.
토픽을 orders.events.v2처럼 새로 만들 때도 기존 토픽 처리 완료 → 생산·소비 경로 전환의 경계가 필요하다. 서비스를 멈출 수 없다면 키별 라우팅·처리 완료를 조율하는 별도 이전 설계가 필요하다.
5. 보관 정책과 복제
토픽의 데이터는 시간이나 크기 기준으로 지우도록 설정하고, 지우지 않게 둘 수도 있다. 오래 두면 저장소 사용량이 계속 늘어 비용이 커진다.
- 보관(
cleanup.policy=delete): 소비 여부와 무관하게 시간(retention.ms) 또는 파티션 크기(retention.bytes) 기준으로 오래된 세그먼트를 지운다. 장애 복구에 걸릴 수 있는 최대 시간보다 길게 잡는다. - 압축(
cleanup.policy=compact): 키별 최신 값을 남겨 현재 상태를 복원할 때 사용한다. 오래된 변경 이력 전체를 다시 읽는 용도에는 맞지 않는다. 두 정책을 함께 설정할 수도 있다. - 복제 계수: 파티션별 복사본 수. ex)
3이면 리더 1개와 팔로워 2개를 서로 다른 브로커에 둔다. 복제본은 장애 대비용이며 컨슈머 병렬성은 늘리지 않는다. 파티션별 리더와 복제본 위치는kafka-topics.sh --bootstrap-server <broker> --describe --topic orders.events로 본다.
실무 판단
주문 상태 변경 이벤트는 orders.events 토픽에 orderId를 키로 보내 주문별 순서를 지킨다. 결제 서비스가 처리할 이벤트가 늘면 컨슈머를 추가하되, 파티션 수보다 많이 늘려도 일반 그룹의 병렬 소비는 늘지 않는다. 장애 뒤 재처리할 기간을 정해 보관 기간을 설정한다.
참고: Kafka 공식 소개 · 토픽 운영·증설 · 토픽 설정