02 비동기로 빼기 전에 알아야 할 것, 유실·중복·순서와 처리 방식 총정리
비동기 처리는 작업을 HTTP 응답 경로 밖으로 빼서, 요청이 그 작업의 완료를 기다리지 않게 하는 설계다. 주문 API에서 알림 발송을 응답 뒤로 빼면 응답은 빨라진다. 대신 새로 답해야 할 것이 생긴다. 주문을 저장한 직후 서버가 죽으면 그 알림은 누가 다시 보내는가? 같은 알림이 두 번 가면? "주문 취소"가 "주문 생성"보다 먼저 처리되면? 이 글은 한 가지 질문을 따라간다.
작업을 응답 뒤로 빼면 무엇을 얻고 무엇을 떠안으며, 떠안은 것을 어떤 방식으로 감당하는가?
위에서 아래로 읽는다. 뺄지 정하고(1절), 뺀 작업을 어디에 둘지 정하면(3절), 그 선택에 따라 떠안는 문제가 정해진다(4절). 그림 속 용어는 해당 절에서 설명한다. 미리 짧게 풀면, Outbox는 보낼 메시지를 업무 데이터와 같은 DB 트랜잭션으로 저장하는 패턴이고, DLQ는 처리하지 못한 메시지를 따로 모아 두는 곳이고, 사가는 여러 서비스에 걸친 작업을 단계별 보상으로 맞추는 방식이고, 대사는 원본과 대상을 주기적으로 맞춰 보는 작업이다.
이미지 출처: 자체 작성 (이 글의 1~9절 기준)
이 글은 큰 그림과 고르는 기준을 다룬다. 각 장치의 구현 세부보다 "무엇이 어디서 깨지고, 무엇으로 막는가"에 집중한다. 기준 버전은 JDK 21, Spring Boot 3.5(Spring Framework 6.2)이고, Kafka 동작은 Kafka 4.x 문서로 확인했다.
1. 응답 경로에서 무엇을 뺄 수 있나
응답 경로에는 응답을 만드는 데 꼭 필요하지 않은 일이 섞여 있기 쉽다. 그런 일을 응답 뒤로 빼면 아래를 얻는다.
| 상황 | 비동기로 얻는 것 | ex) |
|---|---|---|
| 응답에 꼭 필요 없는 부수 작업이 응답 경로에 있다 | 응답 시간 단축 | 주문 후 알림, 포인트 적립, 검색 색인 |
| 연동 대상이 자주 느리거나 실패한다 | 장애 격리: 연동 실패가 기능 실패로 번지지 않는다 | 푸시 서버 장애에도 주문은 성공 |
| 유입이 순간적으로 처리 능력을 넘는다 | 부하 평탄화: 버퍼가 피크를 흡수한다 | 이벤트 오픈 때 포인트 지급 폭주 |
| 같은 사건에 반응할 곳이 계속 늘어난다 | 확장: 보내는 쪽 코드를 안 고치고 받는 쪽만 추가한다. 브로커의 Pub·Sub 구조일 때 얻는다(7절) | "주문함" 이벤트를 정산·추천·통계가 각자 받아 간다 |
| 작업이 HTTP 타임아웃보다 오래 걸린다 | 긴 작업 처리: 접수만 하고 응답, 결과는 나중에 | 리포트 생성, 동영상 인코딩 |
뺄지 말지는 질문 하나로 가른다. 지금 이 응답을 만들기 전에 그 결과가 필요한가?
- 필요하면 동기로 둔다. 대신 타임아웃·재시도·멱등키로 그 호출을 안전하게 만든다.
- 멱등키는 클라이언트가 요청마다 붙이는 고유 키로, 같은 키로 다시 온 요청은 새로 처리하지 않고 처음 결과를 돌려주게 한다.
- ex) 승인 성공·실패를 바로 보여줘야 하는 결제 API.
- 결과가 필요하긴 한데 응답 뒤에 필요하면 뺄 수 있다. 그동안의 상태를 사용자에게 보여준다.
- ex) 결제 승인 이벤트를 받아 주문을 확정하고, 그 사이 화면에는 "결제 확인 중"을 띄운다.
- 결과가 필요 없으면 뺀다. ex) 주문 완료 알림.

비동기로 빼면 응답은 접수 직후에 나간다. 그 대가로 응답과 작업 완료 사이에 "접수됐지만 아직 안 끝난" 구간이 생긴다.
빼는 순간 "요청은 성공했는데 작업은 아직(또는 끝내) 안 된" 상태가 생긴다. 그래서 두 가지를 더 묻는다.
- 그 시차를 업무가 허용하는가?
- 작업이 실패하면 재시도하거나, 나중에 사람이 처리하거나, 무시할 수 있는가?
둘 중 하나라도 "아니오"면 동기로 둔다.
2. "비동기"라는 말이 가리키는 두 층
1절의 이득은 모두 작업을 응답 경로 밖으로 넘겨서 얻는다. 그런데 "비동기"는 프로세스 안에서 스레드를 아끼는 기법을 가리킬 때도 쓰인다. 두 뜻이 섞이면 대화가 자주 엇갈린다.
| 층 | 여기서 "비동기"의 뜻 | ex) | 얻는 것 | 주로 다루는 문제 |
|---|---|---|---|---|
| 시스템 연동 (응답 경로 밖) | API 서버가 작업 완료를 기다리지 않고 접수만 한 뒤 클라이언트에 응답한다 | @Async, 메시지 큐, Outbox, 배치, 202 Accepted | 1절의 이득 | 유실·중복·순서·일관성 |
| 코드 실행 (프로세스 안) | 호출이 결과를 바로 돌려주지 않고, Future·콜백·suspend로 나중에 받는다 | CompletableFuture, 코루틴, Reactor | 자원 효율: IO를 기다리는 동안 스레드를 다른 일에 쓴다 | 스레드 점유·디버깅 |
같은 프로세스의 별도 스레드(@Async)로 넘기는 것도 응답 경로 밖으로 빼는 일이라 시스템 연동 층에서 함께 다룬다. 시스템 연동 층이 곧 메시지 큐를 뜻하지는 않는다. 작업을 스레드나 프로세스 너머로 넘기면 ThreadLocal 값이 끊기는 컨텍스트 문제는 두 층 모두에서 생긴다(4.1).
코드 실행 층에는 축이 둘 있다.
- 결과를 언제 받느냐(동기·비동기)
- 기다리는 동안 OS 스레드를 붙잡아 두느냐(점유·반납)
이 글에서 "블로킹 호출"은 코드가 결과를 기다리며 그 자리에 멈추는 호출을 말한다. 블로킹 호출이 OS 스레드를 점유하는지 반납하는지는 그 아래 스레드에 달렸다. 두 축은 따로 움직인다.
ex) Future.get()은 비동기로 시작해 놓고, 결과를 기다리는 동안 스레드를 점유한다.
ex) 가상 스레드(JVM이 관리하는 가벼운 스레드, 5절) 위의 JDBC 호출은 결과를 그 자리에서 받는 동기 호출이고, 코드 입장에서는 블로킹 호출이다. 하지만 기다리는 동안 밑의 OS 스레드는 반납된다(JDK 21에서 synchronized 안이면 반납하지 못하는 예외가 있다, 5절). 같은 호출을 플랫폼 스레드(OS 스레드와 1:1로 묶인 기존 스레드)에서 하면 OS 스레드를 점유한다.
왼쪽은 "비동기"가 쓰이는 두 층이다. 오른쪽은 코드 실행 층 안에서 결과를 받는 시점(동기·비동기)과 대기 중 OS 스레드 점유·반납이 서로 독립인 두 축이라는 점을 보여 준다. 가상 스레드의 반납에는 5절에서 볼 예외(pinning)가 있다.
이미지 출처: 자체 작성 (JEP 444: Virtual Threads 기준)
유실·중복 같은 신뢰성 문제는 시스템 연동 층에서 생긴다. 코루틴으로 바꿨다고 메시지가 덜 사라지지는 않는다. 3·4절은 시스템 연동 층을, 5절은 코드 실행 층을 다룬다.
3. 뺀 작업은 어디에 두나
응답 경로에서 뺀 작업은 처리될 때까지 어딘가에 머문다. 머무는 곳은 크게 셋이다. 어디에 두느냐가 4절의 문제 중 무엇을 떠안을지를 정한다.
| 보관 위치 | 동작 | ex) |
|---|---|---|
| 메모리 | 같은 프로세스의 실행기 큐에 넣고, 다른 스레드가 꺼내 처리한다 | @Async, ThreadPoolTaskExecutor |
| 브로커 | 별도 서버(브로커)에 메시지를 보내고, 소비자가 받아 처리한다. 흔히 메시지 큐라고 부른다 | Kafka, RabbitMQ, Amazon SQS |
| 업무 DB | 업무 데이터와 같은 DB의 테이블에 작업을 기록하고, 다른 프로세스가 읽어 처리한다 | outbox 테이블(4.3), Task Queue, 배치가 읽는 원본 테이블 |
이 글에서 "메시지 큐"는 브로커를 가리킨다. 메모리 큐도 큐지만, 프로세스 안에 있어서 성질이 다르다. 업무 DB에 두는 방식은 쓰임이 셋이다.
- outbox 테이블은 브로커로 보낼 메시지를 잠시 담아 둔다.
- Task Queue는
status컬럼을 두고 워커가 직접 꺼내 처리한다. 작업 행을 쌓아 두는 테이블을 큐처럼 쓰는 방식이다.- ex) 우아한형제들은 30분 넘게 걸리는 엑셀 생성 작업을 Kafka 대신 RDB 기반 Task Queue로 처리한다(우아한형제들 기술블로그).
- 배치는 업무 테이블 원본을 주기마다 읽는다.
세 곳은 세 가지 성질이 다르다.
- 프로세스가 죽으면 남는가
- 메모리 큐는 프로세스와 함께 사라진다.
- 브로커는 전송이 끝난 뒤부터 남고, 업무 DB는 커밋되면 남는다. 다만 브로커도 보관 기간이 지난 메시지는 지운다.
- ex) Kafka 토픽
retention.ms기본 7일, Amazon SQS 기본 4일.
- ex) Kafka 토픽
- 처리가 실패하면 다시 전달되는가
- 브로커는 소비자가 "처리했다"고 알리기 전까지 메시지를 다시 줄 수 있다.
- 업무 DB는 행이 남아 있으니 다시 읽으면 된다.
- 메모리 큐는 기본적으로 다시 주지 않는다.
- 업무 데이터와 한 트랜잭션으로 쓰는가
- 업무 DB에 두면 업무 데이터와 같은 트랜잭션으로 묶인다.
- 브로커는 별도 시스템이라 묶이지 않는다.
두 번째 성질은 전달 보장으로 이어진다. 전달 보장은 메시지 하나가 몇 번 처리되느냐에 대한 약속이고, 셋으로 나눈다.
- 최대 한 번(at-most-once): 한 번 처리되거나 사라진다. 두 번 처리되지는 않는다.
- 적어도 한 번(at-least-once): 사라지지는 않지만 두 번 이상 처리될 수 있다.
- 정확히 한 번(exactly-once): 한 번만 처리된다. 성립하는 범위가 좁다(4.4).
다시 전달하지 않는 메모리 큐의 기본은 최대 한 번이고, 다시 전달하는 브로커와 업무 DB의 기본은 적어도 한 번이다.
메모리는 다시 할 근거가 없어 최대 한 번, 브로커와 업무 DB는 다시 전달할 수 있어 적어도 한 번이 기본이다. 브로커는 업무 DB와 따로 써야 해서 둘 사이에 틈이 생긴다(4.3).
이미지 출처: 자체 작성 (Apache Kafka 설계 문서: Message Delivery Semantics 기준)
4. 작업이 손을 떠나면 생기는 문제
동기 호출에도 결과를 모르는 순간은 있다. 상대가 처리한 뒤 응답만 유실되면 호출자는 타임아웃을 받고도 성공했는지 알 수 없다. 그래도 동기에서는 호출자가 그 자리에서 판단하고 재시도할 수 있다. 비동기에서는 작업이 호출자 손을 떠난다. 그래서 작업이 지금 어디 있고, 몇 번, 어떤 순서로 처리됐는지를 따로 설계해야 한다.
모든 문제가 모든 방식에서 생기지는 않는다. 아래 두 표는 문제를 보관 위치(3절의 메모리·브로커·업무 DB)에 따라 달라지는지로 가른다.
먼저 어디에 두든 생기는 문제다. 보관 위치에 따라 모양만 조금 다르다.
| 조건 | 문제 | 보관 위치별 차이 | 보통의 해법 |
|---|---|---|---|
| 어디에 두든 (4.1) | 결과를 모른다 | 없다 | 상태 리소스 |
| 적체 | 셋 다 생긴다. 메모리 큐는 상한이 없으면 OOM으로 이어진다 | 큐 상한, 가장 오래된 작업의 나이 감시 | |
| 순서 역전 | 셋 다 생긴다. 메모리 큐도 여러 스레드가 병렬 처리한다 | 키 단위 순서, 버전 | |
| 컨텍스트·추적 단절 | 메모리는 스레드 경계, 브로커·업무 DB는 프로세스 경계에서 끊긴다 | 컨텍스트 전파, traceparent | |
| 여러 서비스에 걸치면 (4.5) | 되돌릴 수 없음 | 없다 | 사가, 보상 트랜잭션 |
| 마지막 방어선 (4.6) | 설계 밖 불일치 | 없다 | 대사 |
다음은 보관 위치에 따라 결과가 갈리는 문제다.
| 문제 | 메모리 | 브로커 | 업무 DB | 보통의 해법 |
|---|---|---|---|---|
| 유실 (4.2) | 생긴다 | 전송 전, 보관 기간 초과, 처리 전 오프셋 커밋 | 커밋 전에만 | 브로커나 업무 DB에 둔다 |
| 이중 쓰기 (4.3) | 4.2의 유실로 다룬다 | 생긴다 | 안 생긴다 | Transactional Outbox |
| 중복 (4.4) | 재시도를 붙이면 생긴다 | 생긴다 | 생긴다 | 받는 쪽 멱등 처리 |
| 독 메시지 (4.4) | 재시도를 붙이면 생긴다 | 생긴다 | 생긴다 | 백오프·지터, DLQ |
| 멈춘 작업 (4.4) | 프로세스와 함께 사라진다 | 브로커가 다시 전달한다 | Task Queue는 직접 회수 | 임대(lease), 실행 토큰 |
4.1 어디에 두든 생기는 문제
결과를 모른다
요청자는 접수 응답만 받는다. 작업이 끝났는지, 실패했는지는 따로 알려 줘야 한다. 그래서 ==작업 상태를 조회할 수 있는 리소스==로 드러낸다. 상태에 무엇을 담고 요청자가 어떻게 받아 가는지는 6절에서 다룬다.
적체
작업이 쌓이는 곳이 있으면 적체(백로그)도 생긴다. 메모리 큐, 브로커, outbox 테이블 모두 같다. 유입이 처리 능력을 넘어도 큐가 받아 주니 보내는 쪽 지연·에러율은 정상으로 보인다. 큐는 내구성이나 버퍼를 주는 대신 문제를 늦게 드러낸다.
그래서 AWS Builders' Library는 큐 길이보다 큐에 있는 메시지의 나이를 재서 뒤처짐을 잡으라고 권한다. Amazon SQS라면 가장 오래된 메시지의 나이를 보여 주는 ApproximateAgeOfOldestMessage 지표가 이 역할을 한다. outbox 테이블이라면 아직 안 보낸 행 중 가장 오래된 created_at이 같은 값이다. 쌓인 뒤의 회복도 비싸다. AWS Builders' Library는 한 시간 장애에서 회복하려면 복구 뒤 한 시간 동안 시스템 처리 능력의 두 배가 필요하다고 적는다. 처리 능력이 평소 유입에 맞춰져 있다고 하자. 복구 뒤 한 시간 안에 비우려면 쌓인 한 시간 분량과 그동안 새로 들어오는 한 시간 분량을 함께 처리해야 한다. 그래서 처리 능력이 평소 유입의 두 배는 되어야 한 시간 장애의 적체를 한 시간 안에 비운다. 능력이 그보다 작으면 회복은 그만큼 더 길어진다.
메모리 큐는 사정이 더 나쁘다. Spring Boot가 @Async용으로 자동 구성하는 실행기는 코어 스레드 8개에 상한 없는 큐를 쓴다(9절). 최대 스레드 수 설정도 있지만, 큐가 가득 찰 때만 스레드를 늘리므로 큐에 상한이 없으면 8개를 넘지 않는다. 처리가 밀리면 큐가 메모리를 계속 차지해 OOM으로 이어진다. 메모리 큐라면 상한과, 가득 찼을 때 어떻게 거부할지(거부 정책)를 함께 정한다.
큐 길이는 얼마나 쌓였는지만 알려 주고, 가장 오래된 작업의 나이는 얼마나 늦었는지를 바로 보여 준다. 오른쪽 회복 비용은 쌓인 적체를 비우는 데 평소 유입의 두 배 처리 능력이 필요하다는 위 계산이다.
이미지 출처: 자체 작성 (AWS Builders' Library: Avoiding insurmountable queue backlogs 기준)
순서 역전
작업을 여럿이 병렬로 처리하면 순서가 뒤집힌다. 스레드가 8개인 @Async 실행기도, 소비자가 여럿인 브로커도, 워커가 여럿인 Task Queue도 같다. 실패한 작업을 다시 시도하는 사이(4.4) 뒤의 작업이 먼저 끝나도 뒤집힌다.
전체 순서를 지키려면 병렬 처리를 포기해야 해서 비싸다. 그리고 대부분은 그럴 필요도 없다. 순서가 필요한 범위는 보통 "같은 주문 안"처럼 업무 단위 하나다. 그 단위의 ==키가 같은 작업끼리만 한 줄로 세우면 된다==.
이 장치를 기본으로 주는 것은 Kafka 같은 브로커다. Kafka 토픽은 여러 파티션으로 나뉘고, 순서는 한 파티션 안에서만 지켜진다. 같은 메시지 키는 같은 파티션으로 가므로, 주문 ID를 키로 쓰면 같은 주문의 이벤트는 순서대로, 다른 주문끼리는 병렬로 처리된다. 단, 파티션 수를 바꾸면 같은 키가 다른 파티션으로 갈 수 있어 순서가 깨질 수 있다(03 토픽·파티션 상세 개념). 메모리 큐나 Task Queue에는 이런 장치가 없다. 같은 키를 같은 워커로 보내도록 직접 짜거나, 아래의 버전으로 판단한다.
왼쪽의 파티션은 Kafka의 장치다. 같은 키는 같은 파티션에 들어가 순서가 지켜진다. 그래도 순서가 뒤집혀 도착할 수 있다면, 상태 이벤트는 낮은 버전을 버리고 증분 이벤트는 버리면 안 된다.
이미지 출처: 자체 작성 (Apache Kafka 소개 기준)
키로 막을 수 없는 역전도 있다.
-
웹훅
- 웹훅은 외부 서비스가 이벤트가 생길 때마다 우리 서버의 HTTP 엔드포인트를 호출해 알려 주는 방식인데, 보내는 쪽이 순서를 보장하지 않는 경우가 많다(Stripe는 이벤트를 생성 순서대로 보낸다고 보장하지 않는다).
-
실패한 메시지를 재시도용 별도 큐(Kafka라면 토픽)로 옮겨 나중에 처리하는 경우
- ex) Retry Topic
- 옮긴 메시지는 원래 순서보다 뒤처진다. 이때는 버전으로 판단한다. 버전은 보내는 쪽이 같은 주문이 바뀔 때마다 1씩 올려 메시지에 싣는 값이다. ex) 주문 행의
version컬럼. 메시지가 무엇을 담느냐에 따라 대응이 갈린다.
-
이벤트가 그 시점의 전체 상태를 담는다면, 이미 가진 것보다 낮은 버전은 버려도 된다. ex) 버전 5(취소)를 반영했는데 버전 4(결제 완료)가 늦게 오면 버린다.
-
"포인트 +10" 같은 증분 이벤트에서 낮은 버전을 버리면 변경이 빠진다. 순서대로 적용하거나, 원본에서 최신 상태를 다시 읽어야 한다.
컨텍스트와 추적의 단절
Spring은 현재 트랜잭션, 로그의 MDC(traceId 같은 값), 인증 정보(SecurityContext)를 ThreadLocal에 둔다. ThreadLocal은 스레드마다 따로 있는 저장소라서, 작업이 다른 스레드로 넘어가면 이 값들이 따라가지 않는다. 메모리 큐는 스레드 경계를 넘고, 브로커와 업무 DB는 프로세스 경계를 넘는다. 경계마다 대응이 다르다.
스레드를 넘으면
ThreadLocal값이 비고, 프로세스를 넘으면 메모리 자체가 다르다. 스레드 경계는 데코레이터나 실행기 래퍼로 값을 복사하고, 프로세스 경계는 메시지 헤더에traceparent를 실어 잇는다.이미지 출처: 자체 작성 (W3C Trace Context 기준)
- 트랜잭션: 트랜잭션은 요청 스레드에 묶여 있어 작업 스레드로 넘어가지 않는다. 커밋 전에 넘기면 작업이 아직 커밋되지 않은 주문을 못 보거나, 롤백된 주문의 알림을 보낼 수 있다. 그래서 커밋이 끝난 뒤에 넘긴다.
@TransactionalEventListener는 트랜잭션 안에서 발행한 이벤트를 커밋 뒤(기본phase = AFTER_COMMIT)에 받는 리스너다. 트랜잭션 없이 발행하면 기본적으로 아예 호출되지 않는다.- 이 리스너 안에서 DB에 다시 쓰려면 새 트랜잭션이 필요하다. Spring Framework 6.1부터는 이 리스너에
@Transactional을 붙일 때REQUIRES_NEW나NOT_SUPPORTED만 허용하고, 아니면 시작할 때 예외가 난다(BEFORE_COMMITphase는 6.2.10부터 예외, RestrictedTransactionalEventListenerFactory).
- 로그·관측 컨텍스트: Spring Framework 6.1의
ContextPropagatingTaskDecorator는 작업을 감싸서, 원래 스레드의 관측 컨텍스트 같은 값을 작업 스레드에서 복원한다.- Micrometer의
context-propagation라이브러리가 필요하고, 그 라이브러리에 등록된 값만 복원된다. MDC의 traceId는 Micrometer Tracing을 함께 쓸 때 관측 컨텍스트가 복원되면서 다시 채워진다. 이 데코레이터를 빈으로 등록하면, Spring Boot가TaskDecorator빈이 하나뿐일 때 그것을 자동 구성 실행기에 건다.
- Micrometer의
- 인증 정보: Spring Security의
DelegatingSecurityContextAsyncTaskExecutor로 실행기를 감싸SecurityContext를 넘긴다. - 프로세스 경계: 메모리가 다르니 값을 복사할 수 없다. 메시지 헤더(Task Queue라면 컬럼)에 W3C Trace Context의
traceparent를 실어 받는 쪽이 같은 trace를 잇게 한다.
4.2 메모리에 두면: 유실
@Async나 스레드 풀은 작업을 프로세스 메모리의 큐에 둔다. 프로세스가 끝나면 큐도 함께 사라진다.
- 정상 종료, 기본값: Spring Framework 6.1부터 실행기는 애플리케이션 종료 단계에 참여한다. 컨텍스트가 닫힐 때 실행 중인 작업이 끝나기를 잠시 기다리고(Spring Boot의
spring.lifecycle.timeout-per-shutdown-phase, 기본 30초까지), 그래도 끝나지 않은 작업은 인터럽트하며, 그때 큐에 남은 작업은 실행하지 않고 지운다. - 정상 종료, 종료 대기 설정:
await-termination과await-termination-period를 함께 설정하면 큐에 남은 작업까지 그 기간만큼 기다린다(9절). 기간을 넘기면 더 기다리지 않고 종료를 진행하므로, 남은 작업은 프로세스와 함께 사라진다. - 강제 종료:
kill -9, OOM, 장비 장애에는 기다릴 기회조차 없다.
어느 경우든 무엇이 사라졌는지 남는 기록이 없다. 다시 할 근거가 없으니 결과는 최대 한 번이다.
이미지 출처: 자체 작성 (Spring Framework: ExecutorConfigurationSupport 기준)
메모리 큐의 작업은 기록도 없이 사라진다. 작업이 예외로 끝나도 마찬가지다. 반환 타입이 void인 @Async 메서드의 예외는 AsyncUncaughtExceptionHandler로 가고, 기본 구현은 로그만 남긴다. 유실을 허용할 수 없다면 작업을 브로커나 업무 DB 같은 영속 저장소에 둔다.
받는 쪽에서도 같은 원리가 적용된다. 외부에서 웹훅을 받을 때는 서명 검증 → 업무 DB에 저장 → 2xx 응답 → 업무 처리 순서로 간다. Stripe도 복잡한 로직 전에 빨리 2xx를 돌려주고, 업무 처리는 비동기로 하라고 안내한다. 2xx를 저장보다 먼저 보내면, 그 사이에 죽었을 때 이벤트가 그대로 사라진다. 보내는 쪽은 2xx를 받았으니 다시 보내지 않는다. 받은 이벤트를 메모리 큐에만 넣고 2xx를 보내도 결과는 같다.
4.3 DB와 브로커에 따로 쓰면: 이중 쓰기
브로커에 둔다고 끝이 아니다. 주문은 업무 DB에, 이벤트는 브로커에 써야 하는데 둘은 한 트랜잭션으로 묶이지 않는다. "DB 커밋 → 브로커 전송" 순서면 그 사이에 죽었을 때 주문은 있는데 이벤트가 없다. 순서를 뒤집어 "전송 → DB 커밋"으로 하면, 커밋이 실패했을 때 없는 주문의 이벤트가 나간다. 두 저장소에 따로 쓰는 이 문제를 이중 쓰기(dual write)라고 한다.
커밋 뒤 @Async로 넘기는 것도 엄밀히는 DB와 메모리 두 곳에 쓰는 것이다. 다만 메모리 쪽은 애초에 남지 않으니 4.2의 유실로 다룬다. Task Queue나 배치처럼 업무 DB 안에서 끝나는 방식에는 이중 쓰기가 없다.
흔히 쓰는 해법은 Transactional Outbox다. 보낼 메시지를 업무 데이터와 같은 DB 트랜잭션으로 outbox 테이블에 넣고, 별도의 릴레이(relay)가 그 테이블을 읽어 브로커로 발행한다.
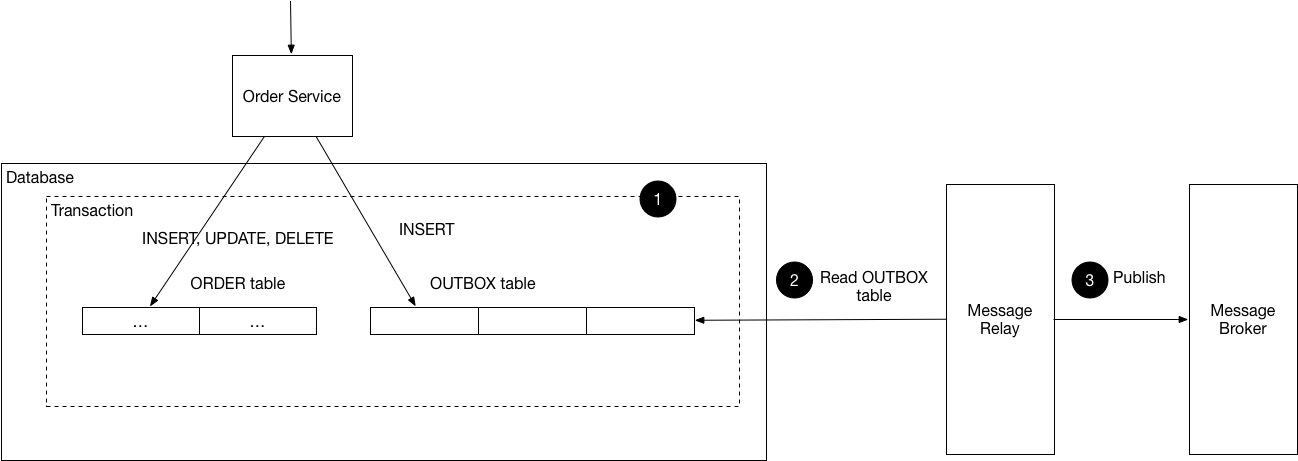
Order Service는 브로커에 직접 쓰지 않는다. 업무 테이블과 OUTBOX 테이블이 한 트랜잭션에 묶이고, Message Relay가 OUTBOX를 읽어 브로커로 발행한다.
이렇게 하면 커밋되면 보낼 근거가 반드시 남고, 롤백되면 메시지도 같이 사라진다. 보장 범위는 "DB 트랜잭션 안에서 업무 데이터와 보낼 메시지가 함께 남는다"까지다. 세 방식을 같은 크래시 시점에 놓고 보면 차이가 분명하다.
같은 시점에 죽어도 작업을 어디에 두었느냐에 따라 결과가 갈린다. 메모리 큐와 메시징 직접 전송은 작업을 잃고, Outbox는 DB에 남은 행으로 다시 보낸다.
이미지 출처: 자체 작성 (microservices.io: Transactional outbox 기준)
대가도 있다. 모든 쓰기 경로가 outbox INSERT를 빠짐없이 해야 한다. 그리고 릴레이가 보낸 뒤 "보냄" 표시 전에 죽으면 같은 행을 다시 보내므로 중복 발행이 생긴다(4.4). 릴레이는 outbox 테이블을 주기적으로 조회(폴링)하거나, DB 변경 로그를 읽는 CDC(7절)로 읽는다. 두 방식의 경계와 Kotlin 코드는 07 DB와 이벤트의 일관성에서 다룬다.
우아한형제들 회원시스템은 이 패턴의 변형을 쓴다. 도메인 데이터와 같은 DB에 이벤트 저장소를 두고 발행 여부 플래그를 함께 저장한다. 첫 발행은 커밋 뒤 리스너가 Amazon SNS(AWS의 발행·구독 메시징 서비스)로 바로 하고, 저장 후 5분이 지나도 발행되지 않은 이벤트는 배치가 찾아 다시 발행한다(우아한형제들 기술블로그).
4.4 다시 시도하면: 중복, 독 메시지, 멈춘 작업
브로커와 업무 DB는 유실을 막으려고 다시 전달한다. 메모리 큐도 재시도를 붙이면 다시 실행한다. 다시 시도하는 순간 이 절의 문제가 따라온다.
중복과 멱등 처리
다시 시도하는 쪽은 앞선 시도가 어디까지 됐는지 모른다. 그래서 일은 했는데 했다는 기록을 남기기 전에 죽으면 같은 작업이 또 온다. 보내는 쪽과 받는 쪽 모두에서 생긴다.
- 보내는 쪽: Outbox 릴레이가 브로커 응답(ack)을 받은 뒤 "보냄" 표시 전에 죽으면, 재시작해서 같은 행을 다시 보낸다.
- 받는 쪽: Kafka 컨슈머는 어디까지 처리했는지를 오프셋(읽은 위치)으로 커밋한다. 메시지를 처리한 뒤 오프셋을 커밋하기 전에 죽으면, 재시작한 컨슈머는 마지막 커밋 위치부터 다시 읽는다(05 컨슈머 심화). Amazon SQS는 받아 간 메시지가 정해진 시간 안에 삭제되지 않으면 다시 보이게 한다.
3절에서 브로커와 업무 DB의 기본이 적어도 한 번(at-least-once)이라고 한 이유가 이것이다.
두 경우 모두 "일은 했는데 했다는 기록을 남기기 전에" 죽어서 중복이 생긴다. 받는 쪽이 메시지 ID를 기록해 두면 두 번째 도착은 건너뛸 수 있다.
이미지 출처: 자체 작성 (Apache Kafka 설계 문서 기준)
받는 쪽이 멱등해야 한다. 같은 메시지를 두 번 처리해도 결과가 한 번 처리한 것과 같아야 한다는 뜻이다. 방법은 셋이다.
| 방식 | 동작 | 장점 | 비용·주의 |
|---|---|---|---|
| 처리 이력 테이블 | 메시지 ID를 UNIQUE 컬럼에 INSERT하고, 충돌하면 건너뛴다 | 어떤 업무 로직에도 쓸 수 있다 | 이력 INSERT와 업무 변경이 같은 DB 트랜잭션이어야 한다. 이력 테이블 정리가 필요하다 |
| 조건부 UPDATE | WHERE status = 'PENDING'처럼 현재 상태를 조건으로 건다 | 테이블을 더 만들지 않는다 | 상태 전이로 표현되는 작업에만 맞다 |
| 덮어쓰기 | 누적(+ n) 대신 원본에서 다시 계산해 덮어쓴다 | 몇 번 와도 결과가 같다 | 원본을 다시 읽는 비용이 든다 |
조건부 UPDATE는 영향받은 행 수로 판단한다. 0행이면 이미 다른 쪽이 처리했다는 뜻이라 그대로 끝낸다. 웹훅도 다르지 않다. Stripe는 같은 이벤트가 두 번 이상 올 수 있으니 처리한 이벤트 ID를 기록해 두고 걸러 내라고 안내한다.
"exactly-once를 지원한다"는 말도 범위를 같이 봐야 한다. Kafka 트랜잭션이 보장하는 exactly-once는 Kafka 토픽을 읽고, 처리하고, 다시 Kafka 토픽에 쓰는 경로까지다. DB나 외부 API가 끼면 Kafka 트랜잭션이 그 결과까지 묶어 주지 않는다. Kafka 설계 문서도 다른 시스템까지 exactly-once로 만들려면 그 시스템의 협조가 필요하다고 적고, 소비자가 오프셋을 처리 결과와 같은 곳에 저장하는 방법을 예로 든다. 실무에서는 위의 처리 이력 테이블처럼 업무 DB 트랜잭션 안에서 멱등 처리로 마무리한다(06 전달 보장과 중복 처리).
재시도 간격과 독 메시지
재시도는 멱등할 때만 한다. 멱등하지 않은 작업을 재시도하면 위의 중복을 스스로 만든다. 간격은 지수 백오프(1초, 2초, 4초…처럼 늘린다)에 ==상한을 두고, ==지터(무작위 흔들림)를 섞는다. 바로 다시 하면 또 실패하고, 모두가 같은 간격으로 다시 하면 재시도가 한꺼번에 몰린다.
몇 번을 해도 실패하는 메시지를 독 메시지라고 한다. 다시 전달하는 방식에서는 독 메시지가 끝없이 돌아온다. Kafka 파티션처럼 순서대로 처리하는 곳에서는 그 뒤의 메시지까지 막는다. 그래서 정해진 횟수 뒤 DLQ(dead-letter queue, 처리 못 한 메시지를 따로 모으는 큐)로 옮긴다. Kafka에서는 같은 역할의 토픽을 DLT(dead-letter topic)라고 부르고, Task Queue라면 FAILED 상태가 이 역할을 한다. AWS Builders' Library는 DLQ에 메시지가 하나라도 들어오면 알람을 건다고 적는다. 고쳐야 할 버그가 있다는 뜻이기 때문이다(Avoiding insurmountable queue backlogs). 독 메시지는 4.1의 나이 지표로도 잘 안 보인다. ex) SQS의 ApproximateAgeOfOldestMessage는 세 번 이상 받아 갔지만 삭제되지 않은 메시지를 계산에서 뺀다.
실패한 메시지는 간격을 늘려 가며 재시도하고, 한도를 넘으면 DLQ로 빠져 알람을 울린다.
이미지 출처: 자체 작성 (AWS Builders' Library: Timeouts, retries, and backoff with jitter 기준)
Spring Kafka에서 재시도와 DLT를 설정하는 방법은 05 컨슈머 심화와 08 Spring Kafka의 Ack와 재시도 전략에서 다룬다.
멈춘 작업
워커가 작업을 받아 처리하다 죽으면, 누군가 그 작업을 다시 꺼내 줘야 한다. 브로커는 이 일을 대신 해 준다. Kafka는 커밋되지 않은 오프셋부터 다른 컨슈머가 이어 읽고, Amazon SQS는 가시성 타임아웃 동안 받아 간 메시지를 숨겨 두었다가 그 안에 삭제되지 않으면 다시 보이게 한다. 다만 늦게 돌아온 소비자의 처리까지 막지는 못하므로, 결국 받는 쪽 멱등 처리가 필요하다. outbox 릴레이나 배치는 다음 주기에 같은 행을 다시 읽으니 따로 회수할 것이 없다.
Task Queue는 이 일을 직접 해야 한다. 워커는 WHERE status = 'PENDING'으로 작업을 잡고 RUNNING으로 바꾼다. 처리 중에 워커가 죽으면 작업이 RUNNING에 멈추고, 다른 워커는 PENDING만 잡으니 아무도 다시 하지 않는다.
그래서 작업을 잡을 때 임대(lease) 만료 시각을 함께 기록한다. "이 시각까지는 내가 맡는다"는 표시다. 그리고 임대가 지난 RUNNING 작업을 PENDING으로 되돌려 다시 처리하게 하는 회수 스케줄러를 둔다. 오래 걸리는 작업이면 워커가 처리 중에 임대를 주기적으로 연장한다.
ex) 우아한형제들의 엑셀 생성 Task Queue는 워커가 1분마다 last_heartbeat_at을 갱신하고, 2분 넘게 갱신되지 않은 IN_PROGRESS 작업을 회수 스케줄러가 PENDING으로 되돌린다.
회수만 하면 새 문제가 생긴다. 죽은 줄 알았던 워커가 느렸을 뿐이라면, 뒤늦게 돌아와 새로 잡은 실행의 결과를 덮어쓴다. 그래서 작업을 잡을 때마다 새로 만드는 고유값인 실행 토큰을 함께 기록하고, 완료 처리에 WHERE token = 내 토큰을 조건으로 건다. 회수 뒤 새 워커가 잡으면 토큰이 바뀌므로, 늦게 돌아온 워커의 완료는 0행으로 끝난다.
임대가 지난
RUNNING작업은 회수 스케줄러가PENDING으로 되돌린다. 완료는 자기 토큰이 아직 유효할 때만 성공하므로, 늦게 돌아온 워커는 결과를 덮어쓰지 못한다.이미지 출처: 자체 작성 (Amazon SQS 가시성 타임아웃 기준)
회수 스케줄러는 주기 스캔이라 주의할 점이 셋이다. (status, lease_until) 인덱스가 없으면 매번 풀스캔이 된다. 한 번에 되돌릴 건수에 상한을 둔다. 여러 서버에서 동시에 돌면 같은 행을 두 번 되돌릴 수 있다. 한 대만 돌게 하려면 ShedLock 같은 분산 락(DB 행 하나를 잠금 표시로 써서 여러 서버 중 한 대만 작업을 실행하게 하는 라이브러리)을 건다. 여러 대가 나눠 처리하게 하려면 SELECT … FOR UPDATE SKIP LOCKED로 다른 서버가 잠근 행을 건너뛰고 각자 다른 행을 잡는다. 워커가 작업을 잡을 때도 같은 방법을 쓴다.
4.5 여러 서비스에 걸치면: 사가와 보상
이 문제는 비동기 고유의 문제가 아니다. 동기 호출로 이어도 여러 서비스에 걸친 작업은 한 DB 트랜잭션으로 묶을 수 없다. 다만 비동기로 빼면 실패를 호출한 자리에서 바로 처리할 수 없으니, 실패 이후의 처리도 비동기 단계(메시지나 작업)로 이어야 한다.
방법은 각 서비스의 로컬 트랜잭션을 차례로 이어 붙이고, 중간에 실패하면 이미 끝난 단계를 보상 트랜잭션으로 상쇄하는 것이다. 이 묶음을 사가(saga)라고 한다.
보상을 롤백으로 생각하기 쉽지만 다르다. 각 단계는 이미 커밋됐으니 되돌릴 수 없고, 보상은 완료된 단계의 업무 효과를 업무 규칙에 맞게 상쇄하는 새 작업이다. ex) 잡아 둔 재고 예약을 해제하고, 발급한 쿠폰을 회수한다. 보상도 실패하고 재시도되니 멱등하게 만들어야 한다.
Azure의 사가 패턴 문서는 단계를 셋으로 나눈다.
| 단계 | 뜻 | ex) |
|---|---|---|
| 보상 가능 단계 | 반대 효과를 내는 작업으로 상쇄할 수 있다 | 재고 예약 → 예약 해제 |
| 피벗 단계 | 되돌릴 수 없는 지점. 성공하면 그 뒤는 끝까지 가야 한다 | 외부 결제 승인 |
| 재시도 가능 단계 | 피벗 뒤에 오며, 멱등해서 성공할 때까지 재시도한다 | 배송 요청, 알림 |
피벗 전에 실패하면 이미 끝난 단계를 보상하고, 피벗 뒤에 실패하면 되돌리지 않고 재시도로 끝낸다. 실패할 수 있는 검증을 피벗 앞에 두면 보상할 일이 줄어든다.
이미지 출처: 자체 작성 (Azure Architecture Center: Saga design pattern 기준)
이 예에서 결제 승인은 피벗이라 보상하지 않는다. 결제 뒤 단계가 실패하면 결제를 되돌리지 않고, 뒤 단계를 재시도해서 끝낸다.
4.6 설계 밖 불일치: 대사
4.1~4.5를 다 막아도 버그, 수동 데이터 수정, 재시도 한도 초과는 설계 밖에서 생긴다. 어느 보관 위치를 골랐든 마지막 방어선으로 원본과 대상을 주기적으로 비교하는 대사(reconciliation)를 둔다. ex) 매일 새벽 주문 테이블과 포인트 적립 내역을 주문 ID로 맞춰 보고, 빠진 적립을 찾는다. 규칙으로 판단할 수 있는 차이만 자동 보정하고, 나머지는 알람으로 사람에게 넘긴다.
5. 프로세스 안에서 기다리는 법: 실행 모델
여기부터는 방식을 고른다. 실행 모델, 결과 전달, 연동 방식은 서로 독립이라 함께 쓴다. ex) 코루틴으로 짠 API가 Outbox로 작업을 넘기고, 요청자는 상태를 조회해 결과를 확인한다.
실행 모델은 2절의 코드 실행 층에 속한다. IO를 기다리는 동안 스레드를 어떻게 다루느냐로 갈린다. @Async는 두 번 나온다. 작업을 어디에 두느냐로 보면 메모리 큐(3·4절)이고, 스레드를 어떻게 쓰느냐로 보면 아래 표의 스레드 풀이다.
스레드 풀은 대기 내내 스레드를 붙잡고, 나머지 셋은 대기 중에 스레드를 반납한다. 어느 쪽이든 작업은 프로세스 메모리에 있으니, 프로세스가 죽으면 진행 중이던 작업도 사라진다.
이미지 출처: 자체 작성 (JEP 444: Virtual Threads, Kotlin Coroutines basics 기준)
| 방식 | 동작 | 장점 | 비용·주의 |
|---|---|---|---|
스레드 풀 + Future (@Async, CompletableFuture) | 작업을 풀의 스레드에 넘기고 Future로 결과를 받는다 | 익숙하고 추가 인프라가 없다 | 기다리는 동안 스레드를 점유한다. 큐 상한과 거부 정책이 필요하다 |
| 리액티브 (Reactor, WebFlux) | 적은 수의 이벤트 루프 스레드(준비된 IO 이벤트를 돌아가며 처리하는 스레드)가 콜백으로 결과를 받는다 | 적은 스레드로 많은 연결을 처리한다. 소비자가 request(n)으로 받을 양을 정하는 백프레셔가 내장돼 있다 | 이벤트 루프에서 블로킹 호출을 하면 전체가 멈춘다. 블로킹 호출은 Schedulers.boundedElastic()으로 격리한다. 학습 곡선이 높고 스택 트레이스가 끊긴다 |
| 코루틴 (Kotlin) | suspend 지점에서 스레드를 반납하고, 결과가 오면 이어서 실행한다 | 순차 코드처럼 읽힌다. 구조화된 동시성(코루틴을 부모-자식 트리로 묶는 규칙)으로 실패·취소가 트리를 따라 전파된다 | suspend가 호출 체인 전체로 번진다. 블로킹 라이브러리는 Dispatchers.IO로 격리한다 |
| 가상 스레드 (JDK 21+) | JVM이 관리하는 가벼운 스레드가 블로킹되면, 밑의 OS 스레드(캐리어)를 반납한다 | 기존 동기 코드를 거의 그대로 두고 IO 대기로 인한 스레드 한계를 푼다 | 빨라지는 게 아니라 처리량이 늘어난다. 풀링하지 않는다. 기준인 JDK 21에서는 synchronized 안에서 블로킹하면 캐리어를 붙잡는다(pinning). JDBC 드라이버가 그렇게 짜여 있으면 반납하지 못한다. JDK 24(JEP 491)에서 대부분 해소됐지만, native 코드나 클래스 초기화 중 블로킹은 여전히 붙잡는다 |
먼저 병목이 정말 IO 대기 때문에 생긴 스레드 부족인지 확인한다. DB 쿼리 자체가 느린 거라면 실행 모델을 바꿔도 소용없다. 블로킹 코드베이스라면 코드를 거의 안 고쳐도 되는 가상 스레드부터 검토한다. Spring Boot에서는 spring.threads.virtual.enabled=true로 켜며, 그러면 @Async 기본 실행기도 가상 스레드를 쓴다. 연결 수가 수만 단위이거나 스트림 백프레셔가 필요할 때 리액티브를 고려한다.
넷 다 작업을 프로세스 메모리에 둔다. 실행 모델은 유실을 막지 않는다. 유실이 문제라면 작업을 브로커나 업무 DB에 두는 방식(3절, 7절)과 같이 써야 한다.
6. 요청자에게 결과를 돌려주는 법
4.1에서 본 대로 요청자는 작업이 끝났는지 모른다. 이 절의 방식은 작업이 오래 걸리는데 요청자가 결과를 받아야 할 때 쓴다. 가장 단순한 방식은 202 Accepted + 폴링이다. 202는 RFC 9110에서 "요청은 받았지만 처리는 끝나지 않았다"는 뜻의 상태 코드다.
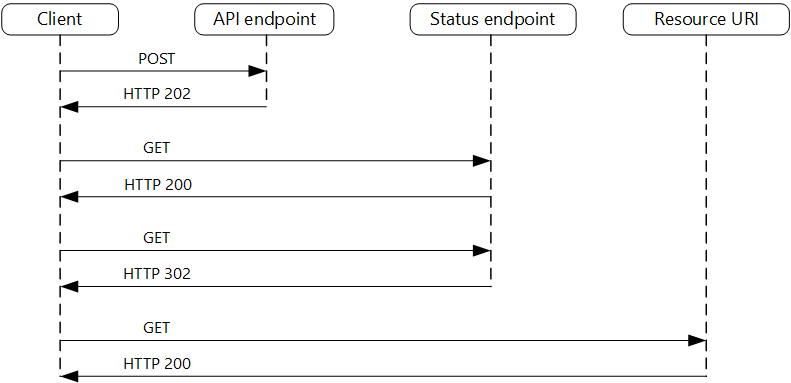
POST는
202 Accepted만 받고 끝난다. 클라이언트는 상태 엔드포인트를 GET으로 확인하고, 진행 중이면 200을, 끝나면303 See Other를 받아 결과 리소스로 간다.이미지 출처: Azure Architecture Center: Asynchronous Request-Reply pattern
202 응답에는 폴링할 주소(Location)와 다음 확인까지 기다릴 시간(Retry-After)을 담는다. 완료 후 리다이렉트는 303을 쓴다. 303은 원래 메서드와 관계없이 결과 리소스를 GET으로 가져오라는 뜻이라 이 패턴과 맞는다. 302는 메서드를 GET으로 바꾼다고 보장하지 않아서, 원래 요청이 POST인 곳에 쓰면 클라이언트에 따라 POST가 다시 나갈 수 있다.
상태 엔드포인트가 돌려줄 값으로 Azure의 비동기 요청-응답 패턴은 아래 필드를 권한다.
status:Pending,Running,Succeeded,Failed,Canceled같은 값createdAt: 접수 시각. 버려진 작업을 찾는 데 쓴다.lastUpdatedAt: 마지막 갱신 시각. 멈춘 작업과 진행 중인 작업을 구분하는 데 쓴다.
status 없이 결과 필드만 두고 "아직 반영 안 됨"을 null로 표시하면, 호출자는 "없음"과 "아직"을 구분하지 못한다.
폴링 말고 결과를 밀어 주는 방식도 있다.
| 방식 | 동작 | 장점 | 비용·주의 |
|---|---|---|---|
| 202 + 폴링 | 클라이언트가 상태 엔드포인트를 주기적으로 조회한다 | 가장 단순하다. 클라이언트 제약이 없다 | 결과 지연이 폴링 간격만큼 생기고, 불필요한 요청이 많다 |
| 웹훅 (서버 → 서버) | 끝나면 서버가 상대 서버의 HTTP 엔드포인트를 호출한다(4.1) | 즉시 통지되고 폴링 부하가 없다 | 공개 엔드포인트와 서명 검증이 필요하다. 웹훅도 다시 보내므로 중복·순서 역전을 전제해야 한다(4.1, 4.4) |
| WebSocket / SSE (서버 → 클라이언트) | 연결을 열어 두고 서버가 결과를 밀어 준다 | 실시간이고 진행률을 보여 줄 수 있다 | 연결 유지 비용이 든다. 서버를 늘리면 연결이 어느 서버에 있는지 찾아야 한다 |
트래픽이 적다면 폴링으로 충분하고, 푸시는 폴링 부하가 실제로 문제가 될 때 고른다.
어느 방식이든 지킬 것이 둘 있다.
202를 돌려주기 전에 요청 검증은 끝낸다. 잘못된 요청은 바로400으로 돌려보낸다.- POST에는 멱등키를 받는다. 클라이언트는 응답이 유실된 건지 요청이 안 간 건지 구분할 수 없어서 같은 POST를 다시 보낸다. 같은 키가 오면 새 작업을 만들지 말고 기존 상태 리소스를 돌려준다.
7. 연동 방식 고르기
3절의 보관 위치를 실제 연동 방식으로 펼치면 여섯이 된다. 메모리는 별도 스레드, 브로커는 메시징 직접 전송, 업무 DB는 Outbox·배치·CDC·Task Queue다. Outbox는 업무 DB에 두었다가 브로커로 넘긴다. CDC는 3절에서 다루지 않은 방식이라 아래에서 설명한다. 여섯 방식을 가르는 것도 보낼 작업을 어디에 보관하느냐다.
여섯 방식은 작업을 메모리, 브로커, outbox 테이블, 업무 테이블 원본, DB 변경 로그, Task Queue 중 어디에 두느냐가 다르다. 업무 DB 안에 근거가 남는 아래쪽 넷은 커밋 뒤 크래시에도 작업이 남는다.
이미지 출처: 자체 작성 (Debezium: Outbox Event Router 기준)
| 별도 스레드 | 메시징 직접 전송 | Outbox | 배치 | CDC | Task Queue | |
|---|---|---|---|---|---|---|
| 작업 보관 위치 | 프로세스 메모리 | 브로커 (전송 성공 후) | 업무 DB의 outbox 테이블 | 업무 DB (원본 그대로) | DB 변경 로그 | 업무 DB의 Task Queue 테이블 |
| 커밋 후 크래시 시 | 유실 | 전송 전이면 유실 | 보존 | 보존 | 보존 | 보존 |
| 떠안는 문제 | 4.1, 4.2 | 4.1, 4.3, 4.4 | 4.1, 4.4 | 4.1, 4.4 | 4.1, 4.4 | 4.1, 4.4 |
| 지연 | 매우 짧다 | 짧다 | 폴링 주기 | 배치 주기 | 짧다 | 폴링 주기 |
| 앱 코드 변경 | 호출부 | 호출부 | 모든 쓰기 경로 | 거의 없다 | 거의 없다 | 호출부, 워커 |
| 운영 부담 | 낮다 | 중간 | 중간 | 낮다~중간 | 높다 | 낮다~중간 |
| 맞는 곳 | 유실돼도 되는 부가 기능 | 받는 쪽이 여럿인 느슨한 결합 | 유실되면 안 되는 업무 이벤트 | 시차가 원래 허용된 대량 데이터 | 쓰기 경로가 많은 레거시, 데이터 복제 | 받는 쪽이 하나이고 브로커가 없을 때 |
별도 스레드는 추가 인프라 없이 코드 몇 줄로 끝나지만, 프로세스가 죽으면 작업이 사라진다(4.2). @Async는 프록시 방식(Spring이 빈을 감싼 대리 객체가 호출을 가로채 다른 스레드로 넘기는 방식)이라 같은 클래스 안에서 호출하면 비동기로 돌지 않는다. Spring 문서도 프록시 모드에서는 같은 클래스 안의 호출을 가로챌 수 없다고 적어 두었다.
메시징 직접 전송은 커밋 뒤 브로커로 바로 보낸다. 브로커가 두 시스템 사이의 버퍼가 된다. 받는 쪽이 느려지거나 죽어도 보내는 쪽은 영향을 덜 받고, 새로 받을 곳은 토픽을 구독하기만 하면 된다(발행·구독). 이 확장성은 메시지가 "주문함" 같은 이벤트일 때 커진다. "포인트 지급해" 같은 커맨드는 보내는 쪽이 여전히 받는 쪽을 안다는 뜻이라 결합이 남는다. 대가는 이중 쓰기(4.3), 중복(4.4), 그리고 브로커 운영이다. 커밋 직후 크래시로 빠진 이벤트가 생기므로, 빠진 건을 대사(4.6)로 메울 수 있을 때만 고른다.
Outbox는 4.3에서 본 대로 커밋과 발행 근거를 원자적으로 묶는다. 대신 릴레이 중복 발행(4.4)을 받는 쪽이 흡수해야 한다.
배치는 정해진 주기마다 쌓인 데이터를 한꺼번에 보낸다. 원본이 업무 DB에 그대로 있어서 실패하면 같은 범위를 다시 돌리면 된다. 하지만 지연이 곧 주기이고 부하가 한 시점에 몰린다. updated_at 기준으로 조회하면 두 가지를 놓친다.
- 늦게 커밋된 트랜잭션: ex) 10:00:59에
updated_at을 쓰고 10:01:05에 커밋된 행은, 10:01:00에 "10:00~10:01" 범위를 조회한 배치가 보지 못하고 다음 배치의 범위에서도 빠진다. - 물리 삭제: 조회할 행 자체가 없다.
CDC(change data capture)는 DB 변경 로그(MySQL binlog, PostgreSQL WAL)를 읽어 전파한다. 어느 경로로 썼든 커밋된 변경은 모두 잡는다. 하지만 행 변경과 업무 이벤트는 다르다. orders.status가 바뀐 것과 "주문 취소됨"은 같은 말이 아니다. 업무 테이블을 직접 CDC하면 내부 스키마가 외부 계약이 되어 버린다. 운영 부담도 가장 크다. 그래서 Outbox 테이블을 CDC로 읽어 릴레이로 삼는 조합이 흔하다. ex) Debezium의 Outbox Event Router.
Task Queue는 브로커 없이 업무 DB만으로 유실을 막는다. 호출부가 업무 데이터와 같은 트랜잭션으로 작업 행을 넣고, 워커가 PENDING 행을 잡아 처리한다. 받는 쪽이 하나뿐이라 브로커의 발행·구독이 필요 없을 때 맞는다. 대신 멈춘 작업 회수(4.4)를 직접 만들어야 하고, 폴링이 DB에 부하를 준다. 아래 판단 순서에서 Outbox + 브로커 자리에 들어갈 수 있다.
고르는 순서는 아래와 같다.
위에서부터 질문에 답하며 내려간다. 결과가 응답 전에 필요하면 동기로 두고, 아니면 유실을 얼마나 견딜 수 있는지로 방식을 고른다. 어느 비동기 길을 고르든 결과 전달·멱등 소비·대사는 따라온다.
이미지 출처: 자체 작성
처음부터 다 갖출 필요는 없다. 유실 비용이 커지는 만큼 별도 스레드 → 메시징 직접 전송 → Outbox 순으로 옮겨 가면 된다. 실행 모델(5절)은 이 흐름과 따로, 스레드가 부족한지를 보고 고른다. 결과 전달(6절)은 요청자가 결과를 기다리는지로 고른다.
즉시 시도 + Task Queue 폴백
Task Queue의 약점은 지연이 폴링 주기라는 점이다. 별도 스레드를 앞에 붙이면 평소 지연을 메모리 큐 수준으로 줄일 수 있다. 업무 트랜잭션에서 작업 행을 PENDING으로 함께 INSERT하고, 커밋 뒤 @Async로 바로 한 번 시도한다. 성공하면 행을 DONE으로 바꾼다. 실패했거나 아예 실행되지 못한 건(메모리 큐가 가득 차 거절됨, 커밋 직후 크래시)은 행이 PENDING으로 남아 있으니, 주기적으로 도는 폴링 워커가 다시 처리한다. 지연은 메모리 큐가 줄이고, 유실은 Task Queue가 막는다. 4.3의 우아한형제들 사례(커밋 뒤 바로 발행하고, 5분이 지나도 발행되지 않은 건은 배치가 다시 발행)와 같은 모양이다.
평소에는 위 줄에서 끝난다. 즉시 시도가 실패하거나 실행되지 못하면 행이
PENDING으로 남고, 유예가 지난 뒤 워커가 처리한다. 유예 구간에는 큐에서 거절된 건도 기다린다. 즉시 시도와 워커가 모두 임대로 잡으면 유예를 없앨 수 있다.이미지 출처: 자체 작성 (우아한형제들 기술블로그: 회원시스템 이벤트기반 아키텍처 구축하기 기준)
대가는 워커 쪽에 생긴다. 워커는 PENDING 행만 보고는 즉시 시도가 아직 처리 중인 행과 실행되지 못한 행을 구분할 수 없다. 바로 잡으면 즉시 시도와 같은 작업을 동시에 처리한다. 그래서 흔히 "생성 N분 뒤부터 재시도 대상"이라는 유예를 둔다. ex) PostgreSQL 기준 WHERE status = 'PENDING' AND created_at < now() - interval '5 minutes'. N은 즉시 시도가 메모리 큐에서 기다렸다가 실행되어 끝날 시간(재시도를 붙였다면 그것까지)보다 길게 잡는다. 우아한형제들이 5분을 고른 것도 SQS 재시도가 최대 5분까지 진행되도록 설정해 두었기 때문이다. 이 유예는 사실상 created_at을 임대처럼 쓰는 방식이다. 4.4의 임대가 "이 시각까지는 내가 맡는다"는 표시였다면, 여기서는 "생성 뒤 N분까지는 즉시 시도가 맡는다"는 표시다. 그래서 4.4의 주의점도 함께 온다. 즉시 시도가 N분보다 오래 걸리면 워커가 같은 행을 잡으므로, 완료 처리는 조건부 UPDATE로 하고 받는 쪽은 멱등해야 한다.
유예를 두면 메모리 큐가 가득 차 바로 거절된 건도, 실행할 스레드가 없었을 뿐인데 유예가 끝날 때까지 기다린다. 이 대기를 없애거나 줄이는 방법은 둘이다.
- 즉시 시도도 임대로 잡는다. 즉시 시도도 워커처럼 조건부 UPDATE로
PENDING을RUNNING으로 바꾸며 임대 만료 시각과 실행 토큰을 남긴다(4.4). 두 쪽이 모두 이 조건부 UPDATE로 잡으면 어느 쪽이 먼저 잡든 한쪽만 1행을 얻으므로, 유예를 없앨 수 있다. 워커가 먼저 잡으면 즉시 시도는 0행으로 끝나고 그대로 물러난다. 메모리 큐가 밀리면 즉시 시도가 행을 잡기까지 큐 길이 ÷ 처리 능력만큼 걸리는데, 그사이 워커가 먼저 잡아 가니 지연도 줄어든다. 임대가 지난RUNNING행은 4.4처럼 회수 스케줄러가 되돌린다. 만료된 임대를 워커의 잡기 조건에 넣으면 회수 스케줄러 없이도 된다. ex) 워커가PENDING행과 함께lease_until이 지난RUNNING행도 바로 잡는다. - 유예를 남긴다면, 거절된 건만 당긴다. 재시도 가능 시각 컬럼(
next_attempt_at)을 두고 INSERT 때 "생성 시각 + N분"으로 채운다. 워커는next_attempt_at이 지난 행을 잡는다. 실행기에 넘길 때 거절되면 그 행의next_attempt_at을 현재 시각으로 당긴다. 스레드 풀 실행기는 기본적으로 거절한 작업에TaskRejectedException을 던진다(Spring Framework 6.2: Task Execution and Scheduling). 이 예외를 앱 코드가 잡으려면 커밋 뒤 리스너는 동기로 두고, 그 안에서 실행기에 직접 제출하며 try/catch로 감싼다.@TransactionalEventListener에@Async를 붙이면 제출이 트랜잭션 완료 콜백(afterCompletion) 안에서 일어나고, Spring이 그 예외를 잡아 로그만 남긴다. 앱 코드는 거절을 알 수 없다. 커밋 직후 크래시처럼 표시할 기회가 없는 건은 원래 유예대로 처리된다.
피크 뒤 쌓인 건은 메모리 큐가 아니라 워커가 처리한다. 평소 지연이 짧다고 회복도 빠른 것은 아니다. 적체를 비우는 속도는 워커 처리 능력(한 번에 잡는 건수, 폴링 주기, 워커 수)이 정한다. 4.1의 회복 비용 계산도 워커 처리 능력을 기준으로 해야 한다.
8. 실무 예시: 알림은 메모리로, 포인트는 Outbox로
주문 API 하나 안에서 두 부수 작업을 다르게 뺀다. 알림은 유실돼도 되니 커밋 뒤 메모리 큐(@Async)로, 포인트 적립은 유실되면 안 되니 Outbox로 넘긴다. 포인트 서비스는 같은 메시지를 두 번 받아도 한 번만 적립한다.
주문 트랜잭션은 주문과 outbox 행을 함께 커밋하고, 포인트 트랜잭션은 처리 이력과 적립을 함께 커밋한다. 번호는 아래 "장애 시점별로 확인하면"의 번호와 같다.
이미지 출처: 자체 작성
흐름은 이렇다.
- 주문 서비스: 한 DB 트랜잭션에서
orders행과outbox행(보낼 포인트 이벤트)을 함께 INSERT한다. - 알림: 커밋 뒤
@TransactionalEventListener가 이벤트를 받고,@Async로 메모리 큐에 넘겨 푸시를 보낸다(4.1, 4.2). - 릴레이: outbox에서 아직 안 보낸 행을 주기적으로(ex) 0.5초마다) 읽어 Kafka의
orders.placed토픽으로 보내고, 브로커 ack를 받은 뒤에만sent_at을 채운다. 메시지 키는 주문 ID(4.1), 메시지 ID는 outbox 행의 ID다. 다시 보내도 ID는 바뀌지 않는다. 앱을 여러 대 띄우면 릴레이도 여러 대에서 돌아 순서가 섞이니, ShedLock 같은 분산 락으로 한 대만 돌게 한다(4.4의 회수 스케줄러와 같은 문제다). - 포인트 서비스: 한 DB 트랜잭션에서
processed_message에 메시지 ID를 INSERT하고(충돌하면 건너뜀) 포인트를 적립한다. DB 커밋이 끝난 뒤 오프셋을 커밋한다.
Outbox 쓰기와 릴레이 코드는 07 DB와 이벤트의 일관성에, 처리 이력 테이블로 멱등 소비하는 코드는 05 컨슈머 심화에 있다.
장애 시점별로 확인하면
- 주문 트랜잭션 커밋 전에 죽는다 → 주문과 outbox 행이 함께 롤백된다. 알림 리스너도 호출되지 않는다. 아무것도 나가지 않는다.
- 커밋 직후, 알림 작업이 메모리 큐에 있을 때 죽는다 → 주문과 outbox 행은 남아 포인트 이벤트는 릴레이가 보낸다. 알림은 사라진다. 이 손실은 처음부터 허용한 것이다.
- 릴레이가 브로커 ack를 받은 뒤
sent_atUPDATE 전에 죽는다 → 다음 주기에 같은 행을 다시 보낸다. 메시지 ID가 같으니 포인트 서비스가 걸러 낸다. - 포인트 트랜잭션 커밋 뒤, 오프셋 커밋 전에 죽는다 → 같은 메시지가 다시 온다.
processed_message에 걸려 건너뛴다. - 포인트 트랜잭션 도중에 죽는다 → 처리 이력과 적립이 함께 롤백된다. 다시 받은 메시지로 처음부터 처리한다.
보장 범위를 정리하면, 주문과 outbox는 DB 트랜잭션으로 함께 남는다. 릴레이에서 Kafka까지는 적어도 한 번이다. 포인트는 처리 이력과 적립이 한 DB 트랜잭션이라 끝단 결과가 한 번만 반영된다. 알림은 최대 한 번이다. 한 번 가거나 사라질 뿐, 두 번 가지는 않는다.
포인트 처리가 계속 실패하는 경우도 정해 둬야 한다. 재시도 한도를 넘긴 메시지는 DLT로 보낸다(4.4). 라이브러리 기본값이 DLT가 아닐 수 있으니 확인한다. ex) Spring Kafka의 기본 에러 핸들러는 10번 실패하면 로그만 남기고 그 레코드를 건너뛴다. 그대로 두면 알람 없이 적립이 누락된다.
9. 설정 기본값 모음
| 설정 | 기본값 | 무엇을 정하나 | 다룬 곳 |
|---|---|---|---|
spring.task.execution.pool.core-size | 8 | @Async 기본 실행기의 코어 스레드 수 | 4.1 |
spring.task.execution.pool.queue-capacity | 상한 없음 (Integer.MAX_VALUE) | 코어 스레드가 모두 바쁠 때 작업을 쌓는 큐의 크기 | 4.1 |
spring.task.execution.pool.max-size | 상한 없음 (Integer.MAX_VALUE) | 큐가 가득 찼을 때 늘릴 수 있는 최대 스레드 수. 큐에 상한이 없으면 큐가 차지 않으니 코어 수 이상으로 늘지 않는다 | 4.1 |
spring.task.execution.shutdown.await-termination | false | 종료할 때 큐에 남은 작업까지 실행할지. false면 실행 중 작업을 종료 단계 제한 시간까지 기다린 뒤 인터럽트하고, 남은 큐는 지운다. true여도 컨테이너 종료는 기다리지 않고 나란히 진행된다 | 4.2 |
spring.lifecycle.timeout-per-shutdown-phase | 30초 | 종료 단계마다 기다리는 최대 시간. await-termination이 false일 때 실행 중 작업을 기다리는 한도이기도 하다 | 4.2 |
spring.task.execution.shutdown.await-termination-period | 없음 (기다리지 않음) | 종료할 때 남은 작업을 최대 얼마나 막고 기다릴지 | 4.2 |
spring.threads.virtual.enabled | false | 가상 스레드 사용 여부. 켜면 @Async 기본 실행기가 가상 스레드를 쓰는 SimpleAsyncTaskExecutor가 된다 | 5 |
@TransactionalEventListener(phase) | AFTER_COMMIT | 리스너를 트랜잭션의 어느 시점에 호출할지 | 4.1, 8 |
@TransactionalEventListener(fallbackExecution) | false | 트랜잭션 없이 발행된 이벤트도 받을지 | 4.1 |
실무 판단
- 뺄지 말지는 "이 응답을 만들기 전에 결과가 필요한가?"로 가른다. 필요하면 동기로 두고 타임아웃·재시도·멱등키로 안전하게 만든다.
- 빼기로 했다면 먼저 작업을 어디에 둘지 정한다. 메모리에 두면 최대 한 번이라 유실을 받아들여야 하고, 브로커나 업무 DB에 두면 적어도 한 번이라 중복을 받아들여야 한다. 유실은 영속 저장소로 막고, 재전달이 만드는 중복은 받는 쪽 멱등 처리로 흡수한다. exactly-once는 Kafka 안이나 한 DB 트랜잭션 안처럼 범위를 좁혀야만 성립한다.
- 결과 확인, 적체, 순서, 컨텍스트, 대사는 어디에 두든 따라온다. 메시지 큐를 안 쓴다고 피할 수 있는 문제가 아니다.
- 코루틴·리액티브·가상 스레드는 스레드를 아껴 줄 뿐, 유실·중복과는 상관없다.
- 유실 비용이 커지는 만큼 별도 스레드 → 메시징 직접 전송 → Outbox 순으로 옮겨 간다. 한 API 안에서도 작업마다 다르게 고를 수 있다(8절).
- 도입 전에 아래를 확인한다.
- 작업이 어디에 보관되는가? 프로세스가 죽으면 어떻게 되는가?
- DB 커밋과 발행 사이에 크래시 구간이 있는가?
- 다시 전달하는 방식이라면, 받는 쪽이 같은 메시지를 두 번 받아도 안전한가?
- 순서가 필요한 범위는 어디까지인가? 그 범위의 키로 줄을 세우는가?
- 재시도 간격·지터, DLQ, DLQ 알람이 있는가?
- 가장 오래된 작업의 나이를 보고 있는가? 메모리 큐라면 상한이 있는가?
- 요청자가 "아직"과 "실패"를 구분할 수 있는가?
- 처리 중에 죽은 작업을 누가 되찾는가?
- 원본과 대상을 대조하는 대사가 있는가?
참고: Azure Architecture Center — Asynchronous Request-Reply pattern · Azure Architecture Center — Saga design pattern · AWS Builders' Library — Avoiding insurmountable queue backlogs · AWS Builders' Library — Timeouts, retries, and backoff with jitter · Amazon SQS — Visibility timeout · Stripe — Receive Stripe events in your webhook endpoint · microservices.io — Pattern: Transactional outbox · 우아한형제들 기술블로그 — 회원시스템 이벤트기반 아키텍처 구축하기 · 우아한형제들 기술블로그 — 장시간 비동기 작업, Kafka 대신 RDB 기반 Task Queue로 해결하기 · Debezium — Outbox Event Router · Apache Kafka — Design: Message Delivery Semantics · Spring Boot — Task Execution and Scheduling · Spring Framework — EnableAsync · Spring Framework — Transaction-bound Events · Spring Framework — ExecutorConfigurationSupport · Spring Framework 6.2 — Task Execution and Scheduling · Spring Framework — RestrictedTransactionalEventListenerFactory · Spring Framework — ContextPropagatingTaskDecorator · Spring Boot 3.5 — TaskExecutorConfigurations 소스 · Spring for Apache Kafka 3.3 — Handling Exceptions · Spring Security — Concurrency Support · Project Reactor — How do I wrap a synchronous, blocking call? · Reactive Streams — README · Kotlin — Coroutines basics · JEP 444: Virtual Threads · JEP 491: Synchronize Virtual Threads without Pinning · W3C — Trace Context · RFC 9110 — HTTP Semantics